Quelles cartes graphiques Nvidia choisir pour l’IA en centre de données ?
novembre 13, 2026/
Le choix d’un GPU NVIDIA pour data center IA dépend d’abord de la charge à exécuter et du format de serveur disponible. L’entraînement de grands modèles manipule des volumes massifs de paramètres et réclame une mémoire HBM très rapide. L’inférence vise souvent le débit, la latence et le coût par requête, avec des besoins de mémoire plus variables. Entre les A100, H100, H200, L40S et T4, l’écart se joue autant sur l’interconnexion que sur le nombre de gigaoctets.
L’entraînement de grands modèles favorise les GPU H100 ou H200, dotés de mémoire HBM et d’interconnexions rapides entre accélérateurs.
L’inférence à fort volume trouve un bon compromis avec les L40S, tandis que les T4 restent adaptés aux charges légères et sobres.
La mémoire disponible doit couvrir le modèle, son contexte et les données intermédiaires sans transfert constant vers la mémoire système.
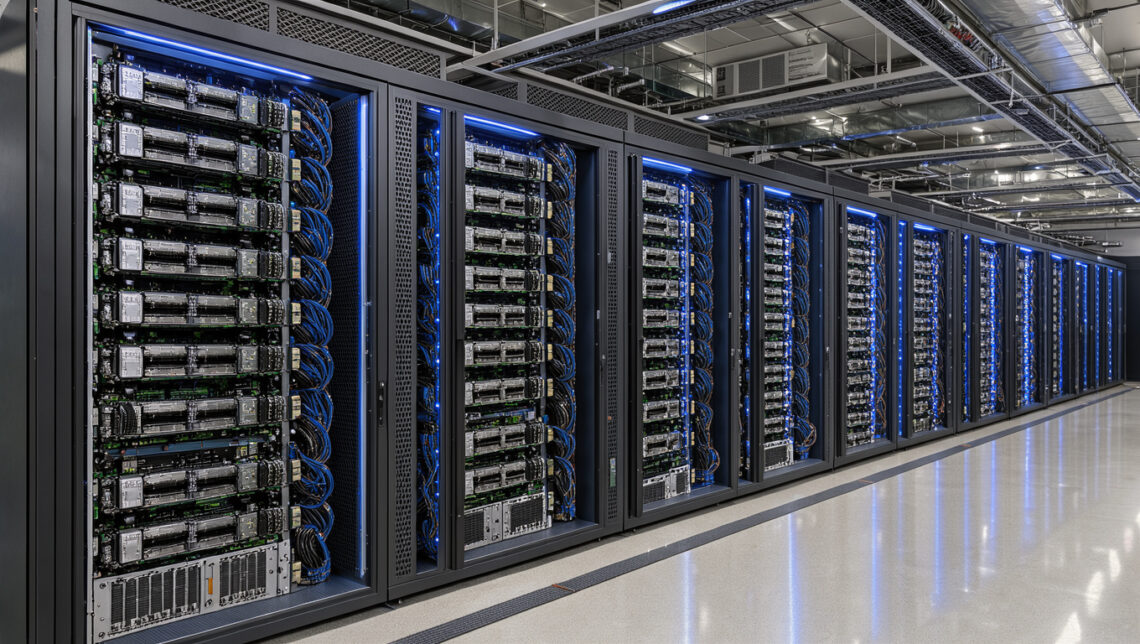
Les GPU haut de gamme exigent des serveurs spécialisés, une alimentation dimensionnée et un refroidissement étudié.
Une carte très puissante devient coûteuse si les modèles sont petits, peu sollicités ou déjà quantifiés.
Les critères qui déterminent le GPU NVIDIA adapté à un data center IA
La capacité et bande passante de la mémoire GPU fixe la taille des modèles exploitables localement. La mémoire HBM offre un débit supérieur à la GDDR6, utile lors des échanges intensifs entre unités de calcul et données. Un modèle de langage de plusieurs dizaines de milliards de paramètres dépasse vite la mémoire d’une carte unique, même après quantification.
Les Tensor Cores accélèrent les calculs matriciels en FP16, BF16 ou FP8. Ces précisions réduites préservent généralement une qualité suffisante pour l’apprentissage moderne, tout en augmentant la vitesse. Le calcul FP32 garde sa place pour certaines étapes scientifiques, mais il pèse davantage sur la consommation.
L’interconnexion compte dès que plusieurs GPU coopèrent. NVLink et PCIe Gen 4 ne répondent pas au même usage. PCIe relie efficacement une carte à un serveur classique. NVLink fournit un lien direct à très haut débit entre accélérateurs compatibles, avantage décisif pour répartir un entraînement sur plusieurs GPU.
La puissance électrique influence enfin le coût réel. Une carte de 70 watts peut convenir à des modèles modestes, alors qu’un accélérateur SXM de 700 watts impose une architecture de rack et de refroidissement adaptée. Un rack dense peut concentrer un volcan de chaleur si les flux d’air et les limites électriques ont été sous-estimés.
Quel GPU NVIDIA choisir pour entraîner des modèles d’IA ?
Pour l’entraînement de modèles d’IA, les A100, H100 et H200 restent les références des infrastructures multi-GPU. L’A100 existe en versions 40 ou 80 Go de HBM2. Elle utilise PCIe Gen 4 et s’intègre dans des plateformes HGX, conçues pour réunir plusieurs accélérateurs.
La NVIDIA A100 40 ou 80 Go demeure pertinente pour des modèles établis, des travaux de recherche et des parcs déjà équipés. Sa génération Ampere propose des Tensor Cores efficaces en FP16 et BF16. Son principal frein apparaît face aux modèles génératifs récents, plus gourmands en mémoire et en bande passante.
Les NVIDIA H100 et H200 reposent sur l’architecture Hopper. La H100 embarque jusqu’à 80 Go de HBM3, tandis que la H200 atteint 141 Go de HBM3e. Cette réserve réduit la nécessité de découper un modèle sur de nombreuses cartes et améliore le traitement des longs contextes. Les formats SXM destinés aux serveurs HGX atteignent toutefois environ 700 watts par GPU.
Un serveur équipé de H100 ou H200 devient cohérent lorsque les temps d’apprentissage ont une valeur métier mesurable. Pour un laboratoire, un service de recommandation ou un modèle interne de taille moyenne, des A100 reconditionnées ou louées peuvent offrir un ratio coût-performance plus raisonnable.
Quels GPU NVIDIA privilégier pour l’inférence IA ?
L’inférence réclame un dimensionnement plus fin. Une plateforme qui sert des milliers de requêtes par seconde privilégie le débit et l’optimisation logicielle. Une application conversationnelle ou industrielle privilégie l’inférence à faible latence, souvent avec des modèles quantifiés en INT8 ou FP8.
La NVIDIA L40S associe 48 Go de GDDR6 à une puissance de calcul adaptée au rendu, à la génération d’images et à l’inférence de modèles génératifs. Son format PCIe simplifie son installation dans des serveurs standards. Elle constitue une option polyvalente lorsque le même cluster doit servir plusieurs équipes.
La NVIDIA T4 16 Go appartient à une génération plus ancienne, mais sa consommation d’environ 70 watts reste un atout. Son interface PCIe Gen 3 et sa mémoire GDDR6 de 16 Go limitent les grands modèles. Elle convient encore à la vision par ordinateur, au transcodage vidéo et aux API d’inférence peu gourmandes.
Les A30 et A10 occupent une position intermédiaire avec 24 Go de mémoire et du PCIe Gen 4. L’A30 utilise de la HBM2, mieux adaptée à certains calculs intensifs. L’A10 emploie de la GDDR6 et répond bien aux tâches de visualisation ou d’inférence généraliste.
Le comparatif des GPU NVIDIA pour serveurs IA
Le comparatif GPU NVIDIA serveur doit intégrer la mémoire, le format matériel et l’énergie, plutôt que les seuls téraflops. Les puissances indiquées sont des ordres de grandeur pour les modèles courants. Elles varient selon le format PCIe ou SXM et le paramétrage du fabricant.
Comparatif des GPU NVIDIA pour serveurs IA
GPU
Mémoire
Interconnexion principale
Puissance typique
Usage recommandé
T4
16 Go GDDR6
PCIe Gen 3
70 W
Inférence légère, vidéo, vision
A10
24 Go GDDR6
PCIe Gen 4
150 W
Inférence et graphisme virtuel
A30
24 Go HBM2
PCIe Gen 4
165 W
Calcul et inférence soutenue
A100
40 ou 80 Go HBM2
PCIe Gen 4 ou NVLink
250 à 400 W
Entraînement multi-GPU
L40S
48 Go GDDR6
PCIe Gen 4
350 W
Inférence générative polyvalente
H100
80 Go HBM3
PCIe Gen 5 ou NVLink
350 à 700 W
Entraînement et IA générative
H200
141 Go HBM3e
NVLink
jusqu’à 700 W
Très grands modèles et longs contextes
Les puissances sont des ordres de grandeur variables selon le format PCIe ou SXM et le paramétrage du fabricant.
Pour un service d’inférence stable et des modèles tenant dans 48 Go, privilégiez la L40S. Pour des modèles de langage volumineux ou un entraînement distribué, les H100 et H200 justifient leur coût grâce à leur mémoire et à NVLink. Pour un parc à faible consommation ou des modèles de vision, la T4 reste rationnelle si 16 Go suffisent.
Les besoins réseau du cluster doivent évoluer au même rythme que les GPU. Les transferts entre serveurs peuvent devenir le goulet d’étranglement d’un entraînement distribué. Les enjeux de débit et de latence recoupent ceux des liaisons très haut débit des data centers.
Le logiciel, la virtualisation et l’énergie complètent le choix du GPU
Un accélérateur NVIDIA intelligence artificielle tire sa valeur de l’outillage logiciel. L’écosystème CUDA rassemble le compilateur CUDA Toolkit, les bibliothèques de calcul et les optimisations CUDA-X AI. Les frameworks d’apprentissage exploitent ainsi les Tensor Cores sans programmation spécifique à chaque carte.
La virtualisation NVIDIA vGPU permet de partager une carte entre plusieurs machines virtuelles, selon les licences et le matériel pris en charge. Cette approche convient aux équipes qui alternent développement, test et inférence. Elle évite qu’un accélérateur onéreux reste inactif entre deux entraînements.
Les systèmes NVIDIA DGX et les plateformes HGX simplifient l’assemblage de GPU interconnectés. Ils réduisent le travail d’intégration, mais représentent un investissement plus élevé qu’un serveur PCIe classique. NVIDIA AI Enterprise apporte un support logiciel pour les déploiements professionnels. Le fournisseur a avancé qu’un cycle de développement pouvait passer de 80 à 8 semaines dans certains scénarios, une estimation qui dépend fortement du modèle, des données et de l’organisation.
Le coût total inclut l’achat, l’électricité, le refroidissement, les licences, le réseau et l’administration. Une H200 peut réduire le nombre de GPU requis pour un modèle exigeant. À l’inverse, une L40S ou une T4 correctement dimensionnée évite de payer une capacité inutilisée.
Questions fréquentes sur les GPU NVIDIA pour data center IA
Quelle différence existe-t-il entre un GPU d’entraînement et un GPU d’inférence IA ?
Un GPU d’entraînement privilégie la mémoire HBM, la bande passante et les liaisons multi-GPU. Un GPU d’inférence recherche le meilleur nombre de requêtes par watt et par euro. Une L40S sert efficacement des modèles optimisés, tandis qu’une H200 cible les modèles très grands ou les longs contextes.
Faut-il choisir une carte PCIe ou une plateforme HGX ?
Une carte PCIe convient aux serveurs standards et aux déploiements progressifs. Une plateforme HGX devient préférable quand plusieurs GPU doivent échanger rapidement durant l’apprentissage. Son intérêt augmente avec la taille du modèle et le nombre d’accélérateurs.
Combien de mémoire GPU faut-il pour un modèle de langage ?
La réponse dépend du nombre de paramètres, de la précision et de la longueur de contexte. Un modèle quantifié peut tenir dans 16 à 48 Go, alors qu’un entraînement exige souvent bien davantage à cause des gradients et des états d’optimisation. Il faut aussi réserver de la mémoire pour les lots de données et les activations.
Une NVIDIA T4 reste-t-elle utile dans un serveur IA ?
Oui, la T4 reste adaptée aux modèles de vision, au transcodage et à l’inférence peu exigeante. Ses 16 Go de mémoire et son interface PCIe Gen 3 limitent les usages génératifs modernes. Sa faible consommation reste intéressante pour densifier des services simples.
Le bon GPU dépend donc du modèle, du volume de requêtes et de l’architecture du serveur. Les H100 et H200 répondent aux entraînements les plus lourds, tandis que les L40S, A30 et T4 permettent de calibrer une infrastructure d’inférence sans surdimensionnement.
Je suis Jérémy, j'ai 30 ans et je suis informaticien. Passionné de high-tech, de cryptomonnaies et d'intelligence artificielle, je consacre mon temps à explorer les dernières innovations et à les intégrer dans mes projets.
Nous utilisons des cookies pour vous garantir la meilleure expérience sur notre site web. Si vous continuez à utiliser ce site, nous supposerons que vous en êtes satisfait.


 Tekin.store


 Ecoportatil.fr


